

El panorama de la asistencia mediante inteligencia artificial en el desarrollo de software avanza a pasos agigantados. Lejos quedan aquellos tiempos en los que pedirle ayuda a una IA se limitaba a corregir un pequeño error puntual o añadir una función muy básica. Para reflejar esta evolución, se acaba de anunciar Android Bench 2.0, una importante actualización de este conocido banco de pruebas diseñado específicamente para medir cómo se desenvuelven los modelos de lenguaje y los agentes en entornos de programación reales y complejos para Android.
Esta nueva versión adapta su metodología al marco Harbor e introduce dos novedades clave: las llamadas tareas de largo recorrido (long-horizon tasks) y la evaluación orientada a agentes. Ya era hora de que las pruebas de rendimiento dejen atrás los parches rápidos y empiecen a medir retos de ingeniería reales.

Tareas complejas y puntuación continua
Hasta ahora, los benchmarks medían cambios incrementales muy acotados. Con Android Bench 2.0, el listón sube considerablemente. Las nuevas pruebas imitan el tipo de trabajo denso que un desarrollador suele delegar, abarcando retos de gran envergadura como:
- Actualizar dependencias complejas.
- Añadir nuevas características desde cero.
- Construir aplicaciones completas sin código previo.
- Migrar aplicaciones multiplataforma directamente a Android.
Además, al enfrentarnos a tareas que pueden llevar a un ingeniero varios días o incluso una semana, el clásico sistema binario de aprobado o suspenso deja de tener sentido. Un modelo puede completar el 90% de los requisitos de una refactorización masiva y fallar en un detalle menor, lo cual antes se traducía en un decepcionante 0%. Ahora se introduce un sistema de puntuación continua que valora la funcionalidad, la fidelidad visual y el cumplimiento de la estructura, arrojando luz real sobre las capacidades arquitectónicas de cada IA.
¿Qué nos enseña esta actualización sobre el estado actual de la IA?
Analizar los resultados de esta nueva hornada de pruebas nos deja conclusiones muy interesantes y evita que caigamos en el marketing exagerado de creer que la inteligencia artificial lo puede hacer todo sola. Por ejemplo, los datos demuestran que las IA son notablemente más hábiles escribiendo código nuevo que refactorizando código ya existente.
Las transformaciones (como pasar de Java a Kotlin o cambiar bibliotecas de red) se ejecutan con solidez incluso en miles de líneas de código. Sin embargo, cuando la tarea exige validación en tiempo de ejecución, lidiar con cambios drásticos de frameworks o enfrentarse a librerías muy recientes, los modelos sufren altibajos importantes.

De hecho, el porcentaje de éxito en las tareas más ambiciosas ronda el 28% de tasa de acierto, lo que demuestra que todavía queda un largo camino por recorrer y que la supervisión humana sigue siendo totalmente imprescindible.
La llegada de los agentes y los nuevos modelos en el podio
Otro de los grandes atractivos de esta versión 2.0 es la integración de evaluaciones basadas en agentes utilizando herramientas propias de cada proveedor de modelos. Combinar arquitecturas de agentes con una buena gestión de la caché de contexto optimiza de manera notable el uso de tokens y mejora la experiencia del desarrollador.
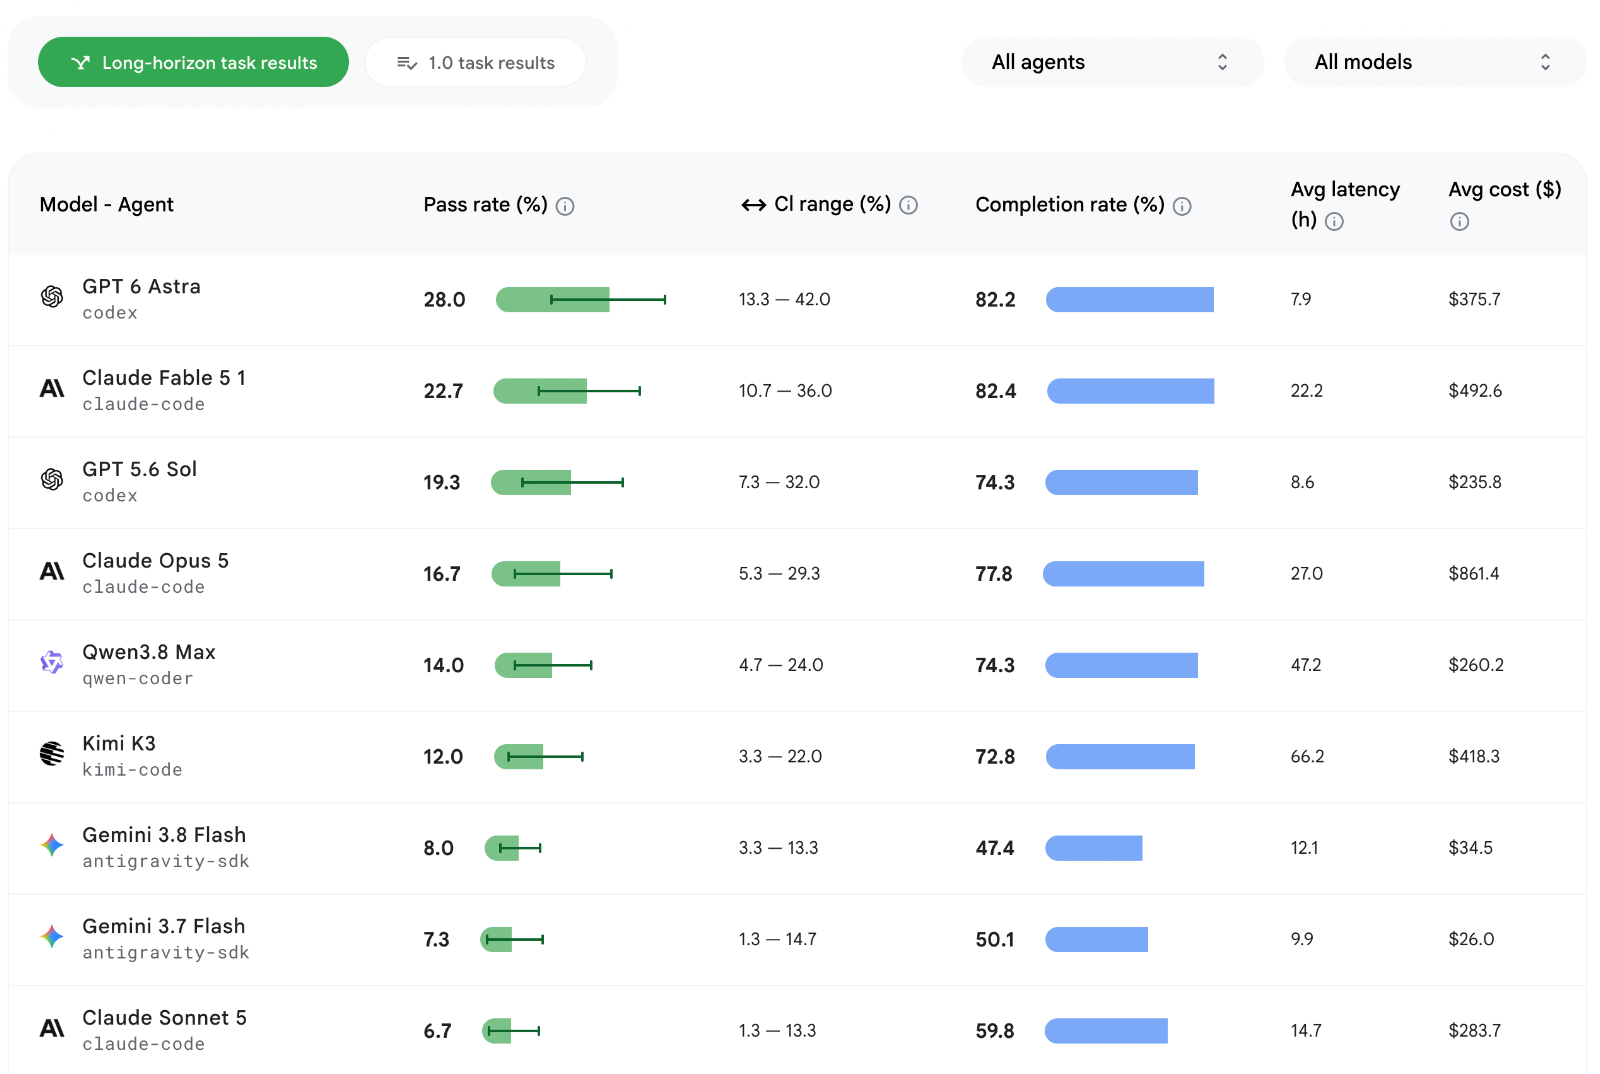
En cuanto al listado de modelos evaluados, la tabla de clasificación se actualiza con la llegada de opciones punteras como Gemini 3.8 Flash, OpenAI GPT-6 o Anthropic Fable 5.1. Lejos de vender una varita mágica, Android Bench 2.0 se posiciona como una herramienta de transparencia fundamental para que los equipos de desarrollo entiendan qué modelo se adapta mejor a sus flujos de trabajo cotidianos sin dejarse llevar por promesas vacías.